所屬科目:國營事業◆1.資料庫及資料探勘 2.程式設計
(一)假設任 2 位教師或導師的姓名皆不相同,請使用 INTERSECT 集合運算撰寫 SQL 查詢,找出所有同時擔任導師的教師姓名。
(二)同上題,請改用 IN 子查詢撰寫 SQL 查詢,找出所有同時擔任導師的教師姓名。
(三)延續子題(一)假設,請使用 GROUP BY 分組運算撰寫 SQL 查詢,找出修習 Jessica 老師所教授之所有課程的學生學號及姓名。
(四)延續子題(一)假設,假設不同學號的學生可能有相同姓名,請使用 JOIN 連接運算撰寫 SQL 查詢,找出與姓名為 Julie 的學生具有相同導師之學生學號及姓名,姓名為 Julie 的學生亦包含在查詢結果中。
(四)延續子題(一)假設,假設不同學號的學生可能有相同姓名,請使用 JOIN 連接運算撰寫 SQL 查詢,找出與姓名為 Julie 的學生具有相同導師之學生學號及姓名,姓名為 Julie 的學生亦包含在查詢結果中。(五)同上題,請改用 IN 子查詢撰寫 SQL 查詢,找出與姓名為 Julie 的學生具有相同導師之學生學號及姓名,姓名為 Julie 的學生亦包含在查詢結果中。
(一)針對交易資料集【Set A】計算 XY 的提升度與 Phi 相關係數,比較 2 個指標所反映項目 X 與項目 Y 的關係,並明確說明各數值大小代表的意義。
(二)針對交易資料集【Set B】計算 XY 的支持度與提升度,並根據 2 個指標說明項目 X 與項目 Y 所呈現的關係。
(三)比較交易資料集【Set A】及【Set B】所算出的指標,分別說明 3 個指標數值的異同及其意義,並據此判斷項目 X 與項目 Y 的關聯程度,回答時必須引用各指標的數值。
(一)給定 2 個初始群中心(initial centroids)為座標 1 與 16,請採用 Kmeans 分群法將這些資料點分成 2 群,反覆進行分群與群中心更新,直到沒有任何資料點改變所屬分群為止。
(二)依據上題的分群結果,分別計算座標 1 與 16 之資料點的輪廓係數(Silhouette coefficient),並說明其數值所代表的分群意義。Silhouette coefficient ?(?) = (?(?) − ?(?))/max {?(?), ?(?)}?(?) =資料點 ? 與同一群中其他資料點的平均距離,?(?) =資料點 ? 與其他各群資料點之平均距離中的最小值。
(三)計算每個資料點的輪廓係數(Silhouette coefficient),再計算各分群的平均輪廓係數,並根據資料分布解釋所得結果。
(一)請寫出【程式碼片段一】執行完畢後的螢幕輸出結果。(7 分)
(二)請寫出【程式碼片段二】執行完畢後的螢幕輸出結果。(8 分)
(一)依序將這 6 個數字插入該 MinHeap 中,請畫出插入這 6 個數字後,最終完成的 MinHeap 樹狀結構。(6 分)
(二)承上題,將 MinHeap 樹根的最小數字(Root)移除。在移除該數字後,依據 MinHeap 的重整規則(Heapify)進行調整,請畫出重整完成後,最終的 MinHeap 樹狀結構。(6 分)
(三)透過不斷重複「移除 MinHeap 根節點的最小數字並進行重整」的動作,依序取出的數字即可排列成一個由小到大的數列,這種排序演算法稱為堆積排序(Heap Sort)。請問在資料筆數為 N 的情況下,Heap Sort 的最佳(Best Case)、最壞(Worst Case)與平均(Average Case)時間複雜度分別為何?(3 分)
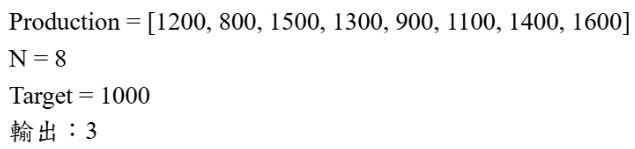
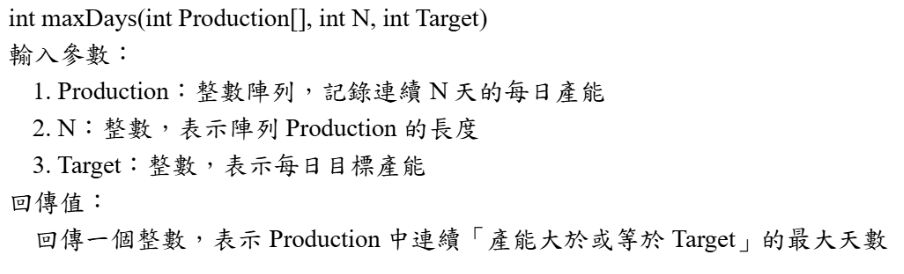
六、某半導體代工廠希望分析每日產能是否能穩定達到生產目標。請撰寫一函式,計算每日產能達到或超過目標值的最長連續天數,並註明所使用的程式語言。(20 分) 函式介面如下:範例: 說明: 產能大於或等於 1000 的連續區段為: ➤ [1200]:連續 1 天 ➤ [1500, 1300]:連續 2 天 ➤ [1100, 1400, 1600]:連續 3 天 因此,最大連續天數為 3
 阿摩線上測驗
登入
阿摩線上測驗
登入
 範例: