所屬科目:iPAS◆中級◆大數據處理分析與應用
1. 工程師使用盒鬚圖(Box Plot)比較三個城市的房價分布,觀察到城市 A 的盒子很短但 鬚很長,城市 B 的盒子很長且對稱,城市 C 的中位數位置明顯偏向盒子下方。依統計 圖形判讀原則,下列敘述何者正確? (A)城市 A 中段房價集中但存在極端值;城市 C 中位數偏低,資料呈右偏分布; (B)城市 A 房價集中且離群值少;城市 C 資料呈左偏分布; (C)城市 B 的盒子較長代表房價變異較大;城市 C 呈左偏分布; (D)盒鬚圖無法判斷偏態,需搭配直方圖才能得出以上結論
2. 下圖為吉尼不純度(Gini Impurity)的計算公式,在決策樹(Decision Tree)中,吉尼不 純度用於評估節點分裂的品質。關於吉尼不純度,下列敘述何者不正確? (A)公式中的 pᵢ 代表第 i 類在該節點中的樣本數,並直接帶入公式計算; (B)公式中的 k 代表節點內資料的類別數量; (C)吉尼不純度用於衡量節點內資料的類別混雜程度,數值越高代表越混雜; (D)當節點內所有樣本屬於同一類別時(完全純淨),吉尼不純度為 0
3. 某物流平台要預測「每小時客服來電數量」,資料顯示平均每小時 12 通,且來電事件 彼此獨立,並在固定時間區間內發生率穩定。工程師在選擇機率模型時,應優先考慮哪 個分布?若實際資料的變異數明顯大於平均數,應如何調整? (A)使用常態分布(Normal Distribution);變異數偏大時改用 t 分布; (B)使用卜瓦松分布(Poisson Distribution) ;變異數>平均數時改用負二項分布(Negative Binomial); (C)使用卜瓦松分布(Poisson Distribution);變異數偏大時增加樣本數即可修正; (D)使用二項分布(Binomial Distribution);變異數偏大時改用卜瓦松分布(Poisson Dstribution)
4. 某工程師使用 MLflow 進行實驗追蹤,評估三種不同學習率(0.001、0.01、0.1)對同 一模型在驗證資料集上的損失表現。每種學習率皆以不同隨機種子重複訓練 10 次,形成三組彼此獨立的樣本資料。經檢查後,這些資料近似常態分布且變異數相近。工程師 希望判斷三組平均損失是否存在顯著差異,同時避免因進行多次兩兩比較而提高第一 類型錯誤率。請問下列何者為最適合採用的統計方法? (A)單因子變異數分析(One-Way ANOVA); (B)獨立樣本 t 檢定(Independent Samples t-test); (C)卡方獨立性檢定(Chi-Square Test); (D)Wilcoxon 符號等級檢定(Wilcoxon Signed-Rank Test)
5. 某 AI 團隊在模型上線後,透過監控系統持續追蹤輸入特徵的分布變化,系統使用 Z- score(Z)作為異常判斷依據,並設定當|Z| ≥ 2 時需觸發警示。假設該特徵近似常態分布,某次監控中發現某特徵值的 Z-score 為-2,請問就實務判讀而言,此數值最可能代表什麼意義? (A)該特徵值低於該特徵歷史平均值 2 個標準差; (B)該特徵值高於該特徵歷史平均值 2 個標準差; (C)該特徵值等於該特徵的歷史平均值; (D)Z-score 為負值代表該數值位於母體分布之外,無法以常態分布解釋
6. 在 AI 模型評估的假說檢定框架中,「女士品茶」實驗是理解型一/型二錯誤的經典案例。實驗中某女士宣稱能分辨 8 杯奶茶中哪 4 杯先加牛奶,若以顯著水準 α=0.05 進行假說檢定,下列敘述何者不正確? (A)虛無假說(H₀)為「女士無此能力(隨機猜測)」,對立假說(H₁)為「女士確實有此能力」; (B)在 α=0.05 下,若女士完全答對(8 選 4 全對) ,其 p 值約為 1/70≈0.014,小於顯著水準,可達統計顯著;(C)若女士完全答對且 p 值<α,則拒絕虛無假說,統計上支持女士有此能力; (D)若女士未完全答對,則「接受虛無假說」,代表確認女士無此能力
7. 某醫療 AI 研究團隊開發了一套個人化用藥劑量推薦系統,並設計實驗評估其效果。研 究團隊招募 40 名高血壓患者,分別在導入 AI 推薦系統前後各測量一次收縮壓,且資 料近似常態分布。研究目標是判斷同一批患者在依據 AI 推薦調整用藥劑量前後,血壓 是否有顯著差異。請問此研究情境應選用哪種統計檢定方法? (A)獨立樣本 t 檢定(Independent Samples t-test); (B)成對樣本 t 檢定(Paired Samples t-test); (C)單因子變異數分析(One-Way ANOVA); (D)魏克遜符號等級檢定(Wilcoxon Signed-Rank Test)
8. 某咖啡店聲稱其平均外送時間為 36 分鐘,母體標準差為 16 分鐘。顧客保護團體抽樣 9 筆訂單,發現平均外送時間為 40 分鐘。若採用右尾 Z 檢定(H₁: μ > 36),顯著水準 α= 0.05(臨界值 Z₀.₀₅ = 1.645),請問 Z 值與檢定結果為何?(參考公式如下圖) (A)Z ≈ 0.08,拒絕虛無假說; (B)Z ≈ 0.08,不拒絕虛無假說; (C)Z ≈ 0.75,拒絕虛無假說; (D)Z ≈ 0.75,不拒絕虛無假說
9. 某生技公司正在進行新型 AI 輔助新藥篩選的臨床試驗,並將顯著水準由 α=0.05 降低 至 α=0.01。在新藥療效安全試驗的情境下,此調整對統計檢定的直接影響為何? (A)降低型二錯誤(Type II Error/β)的發生機率,減少未能偵測到有效藥物的風險; (B)降低型一錯誤(Type I Error/α,偽陽性)的發生機率,減少將無效藥物誤判為有效 並進入後續高成本試驗的風險; (C)增加樣本數以提升統計功效(Statistical Power),進而改善估計精度; (D)降低統計計算過程中的數值誤差,提高 p 值的精確度
10. 某團隊為職業籃球隊建立球員受傷風險預測模型,原始特徵 280 個。初始模型訓練集 AUC 為 0.94、測試集僅 0.68,顯示嚴重過擬合。為改善模型,團隊進行以下處理步驟: 第一步於全體資料(含測試集)上計算特徵間線性相關係數並移除高度相關特徵;第二步依模型重要性篩選特徵後重新訓練模型。最終測試集 AUC 提升至 0.81。關於上述調 整流程,下列敘述何者最為正確? (A)使用相關係數進行特徵篩選方向正確,主要問題在於相關係數門檻設定過高; (B)在全體資料(含測試集)上進行特徵篩選會造成資料洩漏,且線性相關無法捕捉非 線性關係; (C)特徵篩選後需重新對測試集進行標準化,否則會影響模型表現; (D)測試集表現提升代表過擬合已解決,流程可直接部署
11. 某團隊為電信公司建立用戶月租方案續約預測模型,資料集包含兩個類別特徵: 「客服評價」共有 5 個等級(非常不滿意至非常滿意),具明確順序關係;「居住縣市」共有 22 個不同類別,類別之間無順序關係。團隊計劃分別以 Logistic Regression 與 XGBoost 訓練模型,並對上述特徵進行編碼。請問下列哪個編碼方案最適當? (A)兩模型皆將「客服評價」與「居住縣市」進行 One-Hot Encoding,保留全部欄位並使用相同特徵矩陣訓練模型; (B)Logistic Regression 將「客服評價」做 Ordinal Encoding、「居住縣市」以歷史續約率 進行編碼且於資料切分前計算;XGBoost 對兩個特徵皆採 Ordinal Encoding 處理; (C)Logistic Regression 將「客服評價」做 Ordinal Encoding、「居住縣市」進行 One-Hot Encoding 並採 Drop First;XGBoost 將「客服評價」採 Ordinal Encoding,「居住縣市」 以類別型態輸入並啟用 enable_categorical; (D)兩個模型均將「客服評價」以平均續約率進行編碼,「居住縣市」先做 One-Hot Encoding 再以 PCA 降維,並統一作為兩模型輸入特徵
12. 某資料工程師在建構 AI 訓練資料處理流程時,需要處理一個 50GB 的 CSV 檔案,其 大小遠超過系統可用記憶體。他使用 Python 的 Pandas 進行資料前處理,但直接呼叫 頁 pd.read_csv()時出現記憶體溢位(Out of Memory, OOM)錯誤。在不改用其他分散式框 架的前提下,下列哪個參數最能有效解決此問題? (A)nrows=10000:限制僅讀取前 N 筆資料以避免記憶體溢位; (B)usecols=0.5:隨機載入 50%的資料欄位,以減半記憶體使用量; (C)chunksize=10000:分批讀取資料並逐批處理,避免一次載入整個檔案; (D)dtype:指定欄位資料型別以降低記憶體使用量
13. 某電商平台正在重構商品資料架構,需同時支援三個系統:商品管理後台需處理結構 化與半結構化資料(如巢狀庫存與不同類別商品欄位差異) ,並支援複雜條件查詢;AI 推薦系統需儲存高維向量(1,536 維)並進行高效相似度搜尋(高 QPS);即時庫存服 務則要求 ACID 且延遲低於 10ms,以避免超賣。在此情境下,哪種資料庫架構最適合? (A)全部使用關聯式資料庫,透過 JSON 欄位儲存巢狀資料,並以延伸套件支援向量搜 尋,同時以資料列鎖(Row-level Lock)處理庫存扣減; (B)商品資料使用文件型資料庫,向量搜尋使用專用向量資料庫,庫存服務使用關聯式 資料庫,各系統依需求選擇最適合的資料庫; (C)全部使用文件型資料庫,同時處理商品資料、向量搜尋與庫存服務,以統一技術棧 降低維運複雜度; (D)商品與向量資料使用搜尋引擎型資料庫,並以文件更新機制處理庫存扣減
14. 某 AI 平台的資料量已達 PB 級,單一資料庫節點已無法負荷,決定採用分片(Sharding) 策略。下列何者為 Sharding 設計的主要目的? (A)增加資料備份數量以提升安全性; (B)將查詢結果預先計算以降低延遲; (C)將資料水平分割以提升擴展性與負載均衡; (D)將資料壓縮以減少儲存成本
15. 某資料工程師在建構大規模影像資料處理流程時,需要處理數千萬筆訓練影像,並發 :訓練集準確率達 99%,但驗證集僅有 72%。 現模型出現嚴重的過度擬合(Overfitting) 在不改變模型架構的前提下,下列哪一項「資料處理層面」的調整最無法有效改善過度 擬合,甚至可能使問題惡化? (A)在資料處理流程中加入資料增強(Data Augmentation) ,於訓練時動態生成多樣化影像樣本; (B)擴充資料來源,收集更多不同場景與條件的影像,以提升訓練資料分布的多樣性; (C)為了提升資料處理吞吐量(Throughput) ,預先將影像轉為固定特徵並快取(Cache) , 反覆使用相同訓練資料以加速訓練流程; (D)在資料前處理階段進行資料清理,移除標註錯誤或品質不佳的影像資料
16. 某工程師在建立推薦系統時,評估使用奇異值分解(Singular Value Decomposition, SVD) 對使用者-商品評分矩陣進行潛在語意分析(Latent Semantic Analysis, LSA) 。關於 SVD 的數學性質,下列何者不正確? (A)SVD 只能分解方陣(Square Matrix),無法應用於行列數不相等的長方形矩陣; (B)SVD 常用於降維(Dimensionality Reduction) ,透過保留最大的 k 個奇異值來近似原 始矩陣(截斷 SVD); (C)SVD 比 PCA 更一般化,因為 PCA 可視為對資料的共變異數矩陣(Covariance Matrix) 進行的特殊 SVD 運算; (D)LSA 是 SVD 在文字-文件矩陣上的應用,透過截斷 SVD 捕捉詞語與文件的潛在語 意關係
17. 某醫院欲建立一套加護病房(ICU)敗血症預測模型,資料來自 120 位病患之生命徵象 ,每 5 分鐘記錄一次。資料中敗血症相關樣本僅佔 3.2%,屬 (如心率、血壓、體溫等) 於高度不平衡資料。在資料檢查過程中發現數項問題,包括血氧資料會出現 10 至 30 分鐘的連續缺失、部分血壓感測器隨使用時間產生系統性偏高(感測器漂移) 、敗血症 標註時間存在約±2 小時誤差,以及不同病患之正常生命徵象基準差異甚大。請問下列 何種資料處理與建模方式最為適當? (A)將缺失值以整體平均填補,未額外處理感測器漂移,並將敗血症標註區間由 6 小時 擴大至 8 小時以涵蓋時間誤差,模型評估採用 ROC-AUC 作為主要指標; (B)對缺失值進行線性插值,若連續缺失時間過長則刪除該段資料,並以 Z-score 標準 化處理感測器漂移,交叉驗證採隨機切分,未避免同一病患資料同時出現在訓練與測 試集中; (C)刪除所有含缺失值之資料,對資料進行 Min-Max 正規化處理,未考慮病患間差異直 接建模,並以 Accuracy 作為評估指標,交叉驗證採分層 K-Fold 方式進行; (D)對缺失值採前向填補並加入缺失指標特徵,利用感測器 72 小時滾動中位數進行漂 移校正,並處理標註雜訊,同時以個別病患基準建模,交叉驗證採病患分組,評估採 PR-AUC 與 Recall 指標
18. 某零售企業的 AI 工程師正在用關聯規則學習(Association Rule Learning)分析購物籃 資料,評估商品 A 跟商品 B 之間同時購買的關係。關於「支援度(Support)」、「信賴 度(Confidence)」、「提升度(Lift)」三個指標,下列敘述何者正確? (A)信賴度=P(A∩B),即 A 與 B 同時出現的機率,範圍[0,1]; (B)支援度=P(B|A),即 A 出現時 B 也出現的條件機率,範圍[0,1]; (C)提升度=P(A∩B) / [P( A )×P(B )],範圍固定在[0,1]之間; (D)提升度=1 表示 A 與 B 獨立(無關聯),<1 表示負相關,>1 表示正向關聯,因此提 升度並非數值愈大即代表關聯愈強
19. 下圖表為電商平台某時段的交易紀錄(共 8 筆訂單),對圖表內的資料執行 Apriori 演算法,設定最低支援度為 3。請問最終保留下來的最大頻繁項目集為何? (A){A}; (B){A, D}; (C){A, B, E}; (D){B, E}
20. 某電信公司的 AI 反詐欺模型在正常交易佔 99.5%、詐欺交易僅佔 0.5%的類別嚴重不 平衡資料集上訓練。若工程師僅以整體準確率(Accuracy)作為模型選擇的唯一指標, 最可能產生什麼嚴重問題? (A)模型訓練時間會因類別不平衡而大幅增加; (B)一個永遠預測為正常交易的模型即可達到 99.5%準確率,但對詐欺交易的召回率為 0%,使準確率失去判別能力; (C)類別不平衡會導致模型訓練過程出現梯度爆炸; (D)類別不平衡會直接導致模型過擬合,使測試集表現下降
21. 某 AI 平台的資料工程師需要在 Apache Spark 叢集上,對包含 10 億筆使用者行為紀錄 的 RDD/DataFrame 計算整體標準差(Standard Deviation) 。請問下列哪種策略在分散式 環境中最正確且有效率? (A)呼叫 collect()將所有資料傳回 Driver 節點的本機記憶體後,再使用 Python 的 statistics.stdev()計算; (B)先對資料進行全域排序(sortBy),再取中間值計算變異數; (C)將資料輸出為 CSV,再以 Excel 的 STDEV 函數計算; (D)使用 DataFrame.agg({'col': 'stddev'})或 RDD.aggregate()等分散式統計方法,由各 Executor 計算局部統計量後再進行彙總
22. 某連鎖便利商店集團欲建立門市未來 14 天每日銷售額預測模型(500 間門市、3 年歷 史資料) 。資料具有明顯的週期性(週末較高) 、年度季節性(暑假與年末高峰)及長期 成長趨勢,並包含已知節日與不定期事件(如颱風) 。在此情境下,關於資料切分與建 模策略,何者最適當? (A)採隨機切分(80/20) ,使用傳統時間序列模型建模,刪除節日資料避免極端值影響, 並以均方根誤差(RMSE)評估; (B)依時間順序切分(最後 90 天為測試集) ,使用具季節性建模能力的時間序列模型並 加入節日資訊,不處理不定期事件,以平均絕對百分比誤差(MAPE)評估; (C)依時間順序切分並採前進式驗證(Walk-Forward Validation),結合時間序列分解與 機器學習模型,加入時間特徵、滯後與滾動統計特徵,並納入節日與不定期事件資訊, 使用均方根誤差(RMSE)與平均絕對百分比誤差(MAPE)評估; (D)依時間順序切分,直接使用深度學習模型建模,不進行特徵工程,所有門市共用模 型,以平均絕對誤差(MAE)評估
23. Receiver Operating Characteristic(ROC)曲線係由單一分類模型在不同決策閾值下形成,並以真陽率(True Positive Rate, TPR)為縱軸、假陽率(False Positive Rate, FPR)為橫軸。請問下圖中四條曲線,何者最不可能是 ROC 曲線? (A)水平線 A; (B)曲線 B; (C)曲線 C; (D)斜直線 D
24. 某 AI 工程師評估客戶滿意度評分(1–5 分,含有明顯離群值)與退款率(連續型比例 變數)之間的相關性,考慮使用皮爾森(Pearson)、斯皮爾曼(Spearman)或肯德爾 (Kendall)相關係數。關於三者的特性比較,下列敘述何者不正確? (A)皮爾森衡量兩個連續變數間的線性關係強度;斯皮爾曼與肯德爾基於排名(Rank) 計算,對非線性單調關係也適用; (B)斯皮爾曼相關係數的計算公式等價於皮爾森,只是將原始數值替換為其排名後代入 計算; (C)與肯德爾相比,斯皮爾曼對離群值的穩健度更強; (D)三者的數值範圍(相關係數區間)皆相同,均在[-1, 1]之間
25. 某金融機構導入 AI 模型進行信用卡詐欺偵測,由於詐欺交易極為稀少(約佔全部交易 0.3%) ,因此模型在測試階段得到 99.6%準確率(Accuracy) ,被初步認定為「高效模型」。然而在實際上線後,風控部門發現模型幾乎無法攔截詐欺交易,且大量誤判正常交易。 經進一步檢查,發現資料極度不平衡,但模型仍以 Accuracy 作為主要優化與評估指標。 在此情境下,下列何者最適當的改善方向? (A)持續優化 Accuracy 指標以提升整體分類正確率; (B)改用精確率(Precision)作為主要評估指標以降低誤報; (C)引入 Class Weight 或 Cost-sensitive Learning 調整損失函數; (D)移除少數類資料以提升模型穩定性與收斂速度
26. 某電商推薦系統的資料工程師在建構模型特徵時,將使用者的訂單 UNIX 時間戳記(連 續數值)轉換為「早晨(6–12 時) 、下午(12–18 時) 、夜晚(18–6 時)」三個區間類別, 以讓推薦模型更容易學習消費時段規律。在資料前處理中,這種將連續數值轉換為有 序類別的操作最精確的名稱為何? (A)特徵離散化(Feature Discretization); (B)特徵縮放(Feature Scaling); (C)數據降維(Dimensionality Reduction); (D)One-Hot 編碼(One-Hot Encoding)
27. 某 AI 產品的商業分析師在準備月度報告時,需要在單一頁面上同時呈現 1,000 位使用 者的留存率、活躍程度與付費轉換率三項指標,以讓決策層快速掌握整體趨勢。若依據 Edward Tufte 的資料視覺化原則中資料密度(Data Density)的概念,下列何者最符合 此原則的設計方向? (A)將 1,000 筆資料分散至多張圖表(每張顯示約 100 筆),避免單一圖表資訊過載; (B)移除所有圖例、軸標籤與輔助線等非資料墨水(Non-data Ink),使版面最簡潔; (C)在圖表中加入大量裝飾性元素(如色塊、陰影、3D 效果),使視覺效果更豐富; (D)在有限頁面空間中呈現盡可能多的有效資料資訊,同時維持可讀性與清楚的視覺層 次
28. 行銷團隊比較三種廣告投放管道(A/B/C)的轉換率差異,原始數據如下,A:3.2%、 B:3.8%、C:4.0%。若設計圖表時將 y 軸刻意截斷(不從 0 開始) ,造成視覺差異放 大。此做法最可能產生的問題為何? (A)提升資料解析效率並減少認知負擔; (B)增強小幅差異的可視化辨識能力; (C)造成視覺誤導並放大實際差異感; (D)提升圖表計算準確性與數據正確性
29. 某 AI 系統的維運工程師需要在儀表板上呈現「模型推論延遲(ms)隨時間的變化趨 勢」,以便即時監控 服務水準協議(Service Level Agreement, SLA)是否達標(P99<200 ms) 。在資料視覺化的圖表類型選擇上,下列哪種圖表最適合呈現連續數值隨時間變化 的趨勢? (A)面積圖(Area Chart); (B)散佈圖(Scatter Plot); (C)長條圖(Bar Chart); (D)折線圖(Line Plot)
30. 訓練資料共 5,000 萬筆,工程師比較 Batch Size=32 與 Batch Size = 4096 的訓練表現, 發現大批次(Large Batch)雖然訓練較快,但模型泛化能力較差。從最佳化理論角度, 下列何者為此現象最合理的解釋? (A)大批次(Large Batch)計算量過大,GPU 無法有效處理; (B)大批次(Large Batch)梯度估計更穩定,但容易收斂至局部極小值(Local Minima) , 導致泛化能力較差; (C)小批次(Small Batch)因隨機性高,更容易發生梯度爆炸(Gradient Explosion); (D)批次大小(Batch Size)與泛化能力無關,問題出在學習率(Learning Rate)設定
31. 某公司中,A 團隊負責信用評分模型,B 團隊負責詐欺偵測模型,兩團隊皆需要「使用 者過去 30 天交易行為」資料,但各自會進行特徵工程與後續工作。以公司整體管理角 度,下列何者為導入統一管理與共用特徵的主要目的? (A)模型推論延遲過高,導致線上服務回應時間不符合系統即時性需求與使用體驗要 求; (B)降低跨團隊重複開發的維護成本; (C)訓練資料儲存空間不足,造成歷史資料保存與批次訓練流程效率下降問題; (D)模型版本管理混亂,導致不同模型部署與回溯分析困難並增加維運複雜度
32. 某銀行建置貸款違約預測模型,資料共 50,000 筆,其中違約樣本僅 800 筆(佔 1.6%) 。 在模型建置流程中,先對整體資料使用 SMOTE 對少數類進行過採樣,之後再進行訓 練/測試切分,並訓練輕量梯度提升機(LightGBM)模型,並以 AUC-ROC 評估模型 表現。模型在測試集的 AUC-ROC 達到 0.91,團隊認為模型表現良好,準備上線部署。 在模型審查過程中,下列何者為使測試集評估結果失真的主要原因? (A)SMOTE 不適合用於金融違約預測場景,此類高風險業務應一律採用 class_weight 調 整損失函數,而非對資料本身進行過採樣; (B)SMOTE 的過採樣操作在訓練/測試切分之前即對全體資料執行,導致合成樣本資訊 洩漏至測試集,使 AUC-ROC 0.91 虛高而不可信; (C)AUC-ROC 在 1.6%的不平衡場景下過度樂觀,應改用 PR-AUC 作為評估指標,其餘 流程均正確; (D)LightGBM 本身已內建處理不平衡的機制,與 SMOTE 同時使用會造成少數類過度 補償,導致過多誤判
33. 某線上書店希望建立一個多類別書籍推薦模型,根據讀者的「年齡、性別、過去購書類 別偏好評分」等特徵,預測讀者下次最可能購買的書籍主題(共 8 類) 。資料已完整標 註,且資料量達數十萬筆。在模型選型上,除了預測準確率外,也需考量模型訓練效 率、可擴充性,並需支援快速訓練與線上部署。請問下列哪種方法最適合此情境? (A)多類別羅吉斯迴歸(Multinomial Logistic Regression); (B)支援向量機(SVM)搭配 One-vs-One; (C)K-means 分群後將群集標籤作為分類結果; (D)主成分分析(PCA)後再以最大主成分作為分類依據
34. 某電商平台希望建立二元分類模型,根據商品的「價格區間、品牌、顏色、材質」等特 徵,將商品分類為「高銷量(1)」或「低銷量(0)」 。同時希望模型輸出具備可解釋的 機率(如 P=0.73 表示 73%機率為高銷量)。請問下列哪種方法最適合? (A)K-means 分群(K-means Clustering); (B)決策樹迴歸(Decision Tree Regression); (C)羅吉斯迴歸(Logistic Regression); (D)線性迴歸(Linear Regression)
35. 某工程師在開發一個以 Transformer 為基礎的文本分類模型時,發現模型對於詞語順序 的變化不夠敏感,影響語意判斷效果。請問在 Transformer 架構中,位置編碼(Positional Encoding)的主要作用為何? (A)在詞嵌入(Embedding)中加入隨機擾動,以提升模型對輸入變化的泛化能力; (B)在注意力機制中加入遮罩(Mask),限制模型只能關注部分詞語; (C)將輸入序列轉換為可同時運算的向量表示,以提升計算效率; (D)在詞的向量表示中加入位置資訊,使模型能區分序列中不同位置的詞語
36. 某 AI 系統架構師正在為一個電子商務資料湖(Data Lake)設計系統。該資料湖儲存數百億筆使用者點擊紀錄,並作為企業主要的分析資料來源。系統需讓非技術背景的行銷人員能以自然語言查詢數據洞察(如:上個月台北市購買 3C 產品的女性轉換率為何?) ,同時滿足高精確性、可擴展性,支援資料庫層級的權限控管與查詢審計,並確 保查詢結果可由資料庫引擎精確執行。在此情境下,下列何者為最適合的系統架構? (A)協同過濾(Collaborative Filtering) :根據歷史查詢推薦相似問題的答案,無法執行新問題的即時計算; (B)檢索增強生成(RAG) :讓 LLM 檢索相關資料後生成回答,但無法可靠執行大規模數值聚合與精確統計查詢; (C)生成對抗網路(GAN) :用於生成合成資料或模擬數據分佈,可用於資料擴增,但不 適合即時查詢與資料庫聚合運算; (D)Text-to-SQL Agent:由 LLM 將自然語言轉換為 SQL 查詢,交由分散式資料庫執行, 兼顧自然語言彈性與資料查詢精確性
37. 某金融機構將訓練好的信用評分模型開放 API 供合作夥伴查詢。資安團隊警告此設計 可能遭受成員推斷攻擊(Membership Inference Attack) 。下列何者最準確說明攻擊原理 與對應防禦? (A)利用模型對訓練樣本的高信心輸出判斷其是否屬於訓練集;以差分隱私或降低輸出 信心防禦; (B)利用查詢次數與回應頻率差異判斷資料是否在訓練集中;以限制查詢次數防禦; (C)透過模型輸出推測輸入的敏感特徵;以限制輸出資訊防禦; (D)透過大量查詢建立替代模型模擬目標模型;以限制模型存取防禦
38. 某 AI 平台的資料治理工程師正在評估三種去識別化技術的適用場景與強度:K 匿名 (K-anonymity)、差分隱私合成資料(Differential Privacy Synthetic Data)、亂數回應機 制(Randomized Response)。下列敘述何者不正確? (A)K 匿名主要應用於表格型資料,確保每筆記錄在準識別符(Quasi-identifier)組合上 至少與 K-1 筆其他記錄相同,防止個體被唯一識別; (B)差分隱私合成資料是在發布統計查詢結果或訓練模型時直接對原始資料加入雜訊, 以確保單一個體的加入或移除不會顯著改變輸出; (C)亂數回應機制讓受訪者以機率性方式回答敏感問題(如:您是否曾逃稅?) ,賦予個 人對答案的可否認性(Plausible Deniability); (D)三種技術中,只有差分隱私提供可組合且可量化的隱私保證,而 K 匿名與亂數回應 在面對背景知識攻擊或多次查詢時保護能力有限 二、程式題
39. 在建構自動化資料清洗管線時,工程師撰寫一個用於補齊缺失欄位的 Python 函式,如 下圖所示。當此函式連續處理兩筆獨立的資料(row1 與 row2)後,請問第二筆資料 row2['tags']的內容會為何?
(A) ["checked", "tags"]; (B) []; (C) ["checked", "checked"] ; (D) 拋出 KeyError 錯誤,因為字典中沒有 tags 鍵值
40. 下圖為一段分類演算法的 pseudocode,請問最可能對應下列哪一種演算法?(A) K-近鄰(K-Nearest Neighbors, KNN); (B) K-means 分群(K-means Clustering); (C)支援向量機(Support Vector Machine, SVM); (D)隨機森林分類器(Random Forest Classifier)
41. 請問下列哪一種處理方式最為合理? (A) df['daily_earnings'].fillna(df['daily_earnings'].mean(), inplace=True); (B) df['daily_earnings'].fillna(df['daily_earnings'].median(), inplace=True); (C)df['daily_earnings'].fillna(df['daily_earnings'].max(), inplace=True); (D)直接刪除所有遺失資料,因數值型欄位不適合進行補值處理 承上題,團隊在建立預測模型前,先將 region(A、B、C 區)轉換為整數 1、2、3,
42. 承上題,團隊在建立預測模型前,先將 region(A、B、C 區)轉換為整數 1、2、3,即採用標籤編碼(Label Encoding) 。模型上線測試後發現,線性迴歸模型對於 C 區(編碼為 3)的預測收入出現明顯高估,顯示模型可能將編碼值誤解為具有線性大小關係。 若主管要求不得修改原有的特徵編碼方式,必須維持 1、2、3 的整數表示,但希望從 演算法層面降低此類誤解風險,則下列何者最適合作為替代模型? (A)羅吉斯迴歸(Logistic Regression); (B)Ridge 迴歸(Ridge Regression); (C)支援向量機(Support Vector Machine, SVM)搭配線性核函數; (D)隨機森林(Random Forest)
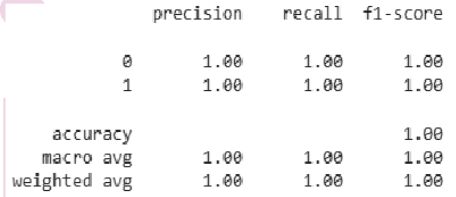
43. 平台安全部門發現, 僅有極少數司機(約 占總體 0.05%)會利 用外掛程式竄改 gps_ping_rate,以騙取里程補貼。某新進資料科學家訓練了一個二元分類模型,並在報告中指出:「模型整體準確率(Accuracy)高達 99.95%,因此可直接上線攔截可疑帳號。」然而,資深工程師檢視後認為,僅憑上述結果(如圖)仍不足以支持模型直接上線。 下列何者不是其提出質疑的合理理由? (A)在此類極度不平衡的資料中,即使模型永遠預測所有司機皆為正常,整體準確率仍可能高達 99.95%; (B)報告中未呈現召回率(Recall),因此模型可能無法有效辨識真正的外掛司機; (C)異常偵測問題不可使用分類模型處理,僅能使用分群或離群值方法; (D)對於少數類比例極低的問題,若僅觀察 Accuracy,可能忽略模型對異常樣本的實際 偵測能力
44. 針對上述外掛偵測模型,營運長下達最終的商業決策目標如下:「對於作弊行為零容忍。 即使誤凍結部分正常司機帳號,後續仍可交由人工覆核;但不能放過任何一個真正的外掛司機。」根據上述目標,團隊在調整模型輸出的決策機率門檻(Threshold,預設為 0.5)時,應採取下列何種策略最為合理? (A)選擇使模型對作弊者的召回率(Recall)最大化的門檻,通常代表應降低 Threshold (B)選擇使模型精確率(Precision)最大化的門檻,通常代表應提高 Threshold (C)固定使用 Threshold=0.5 作為預設值,因為調整門檻將破壞演算法原有的訓練平衡 (D)選擇使模型特異度(Specificity)達到 100%的門檻,以確保正常司機不會被誤判
45. 若分析師想找出「總貢獻營收最高的前 3 名客戶」,下列 Pandas 程式碼何者最為精確 且高效? (A) df.sort_values('Revenue', ascending=False).head(3)['CustomerID']; (B) df.groupby('CustomerID')['Revenue'].max().head(3); (C) df.groupby('CustomerID')['Revenue'].sum().nlargest(3); (D) df.value_counts('CustomerID').head(3)
46. 若分析師只想計算「Electronics(電子產品)」這個特定分類的平均營收,下列何者為 最佳的語法? (A) df[df['Category'] == 'Electronics']['Revenue'].mean(); (B) df['Category' == 'Electronics']['Revenue'].mean(); (C) df.loc['Electronics', 'Revenue'].mean(); (D) df.filter(items=['Electronics'])['Revenue'].mean();
47. 分析師想將 customers 表中的 Region 欄位加入到 df 交易紀錄中,且「只保留那些在 customers 表中有對應資料的交易紀錄」。下列哪一種合併方式最正確? (A) pd.concat([df, customers], axis=1); (B) pd.merge(df, customers, on='CustomerID', how='outer'); (C) pd.merge(df, customers, on='CustomerID', how='inner'); (D) df.join(customers, on='CustomerID')
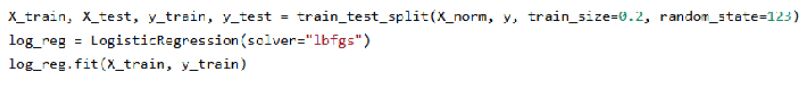
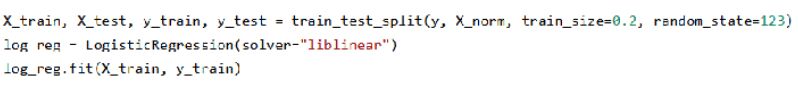
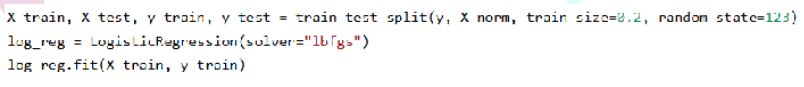
48. 在進行機器學習建模前,資料分析師需對特徵變數 X 進行標準化處理,以消除不同量尺所造成的影響。已知使用 StandardScaler 進行資料轉換,程式碼如下:scaler = StandardScaler()。請問下列哪一種寫法可以正確完成資料標準化? (A)X_norm = scaler.transform(X); (B)X_norm = scaler.fit(X); (C)X_norm = scaler.fit_transform(X); (D)X_norm = fit_transform(scaler) 在進行機器學習建模前,資料分析師已完成資料前處理(包含遺漏值處理與特徵標準
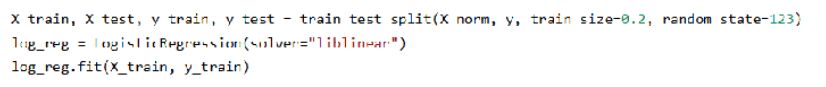
49. 化),並準備建立分類模型。 已知資料流程如下:1. 將資料區分為訓練集與測試集 2. 建立羅吉斯迴歸(Logistic Regression)模型3. 使用訓練資料進行模型擬合(fit) 請問下列哪一組 Pandas / Scikit-learn 程式碼流程最為正確? (A) (B) (C) (D)
50. 參考下圖程式碼,下列描述何者正確?(A)cm 表示混淆矩陣,橫列表測試集的預測值; (B)混淆矩陣對角線數值皆大於非對角線數值表示模型過度擬合; (C)f1_score 參數 average="weighted"表示計算平均 f1_score; (D)f1_score 計算時採用各類別精確率(Precision)與召回率(Recall)的調和平均,並加權考量類別不平衡性
 阿摩線上測驗
登入
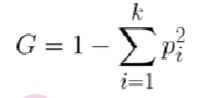 (A)公式中的 pᵢ 代表第 i 類在該節點中的樣本數,並直接帶入公式計算; (B)公式中的 k 代表節點內資料的類別數量; (C)吉尼不純度用於衡量節點內資料的類別混雜程度,數值越高代表越混雜; (D)當節點內所有樣本屬於同一類別時(完全純淨),吉尼不純度為 0
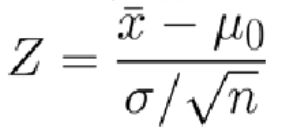 (A)Z ≈ 0.08,拒絕虛無假說; (B)Z ≈ 0.08,不拒絕虛無假說; (C)Z ≈ 0.75,拒絕虛無假說; (D)Z ≈ 0.75,不拒絕虛無假說
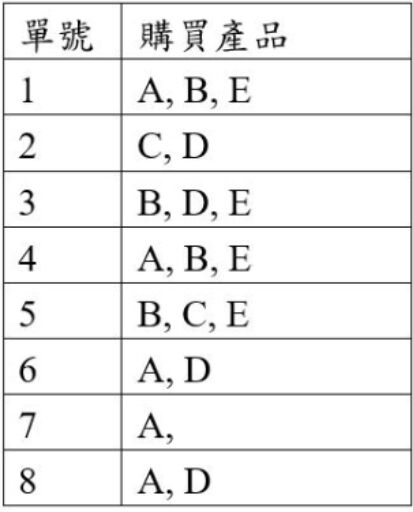 (A){A}; (B){A, D}; (C){A, B, E}; (D){B, E}
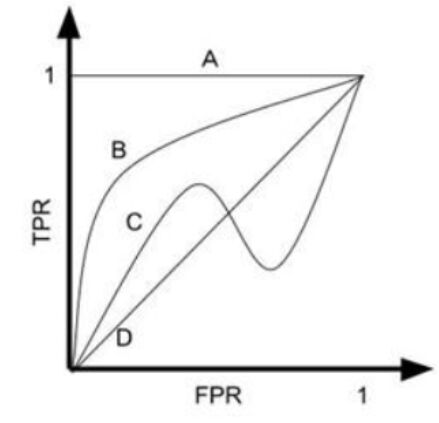 (A)水平線 A; (B)曲線 B; (C)曲線 C; (D)斜直線 D
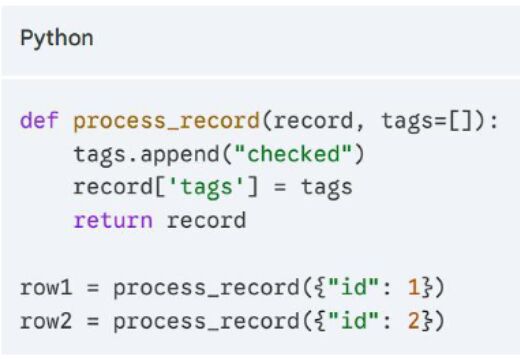 (A) ["checked", "tags"]; (B) []; (C) ["checked", "checked"] ; (D) 拋出 KeyError 錯誤,因為字典中沒有 tags 鍵值
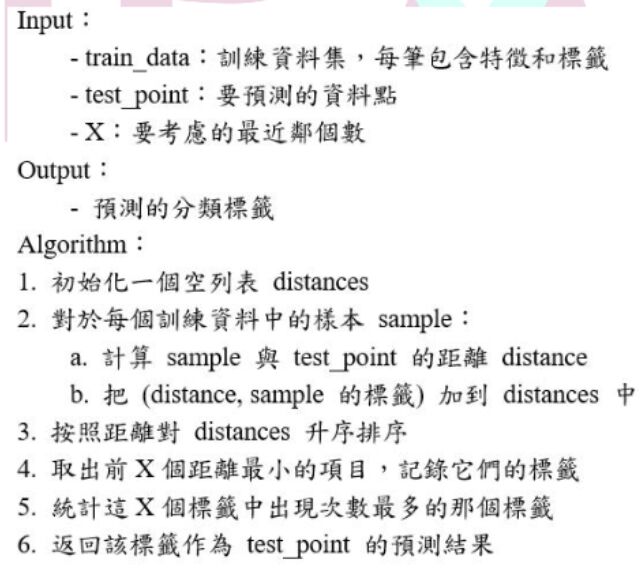 (A) K-近鄰(K-Nearest Neighbors, KNN); (B) K-means 分群(K-means Clustering); (C)支援向量機(Support Vector Machine, SVM); (D)隨機森林分類器(Random Forest Classifier)
 (B)
 (C)
 (D)
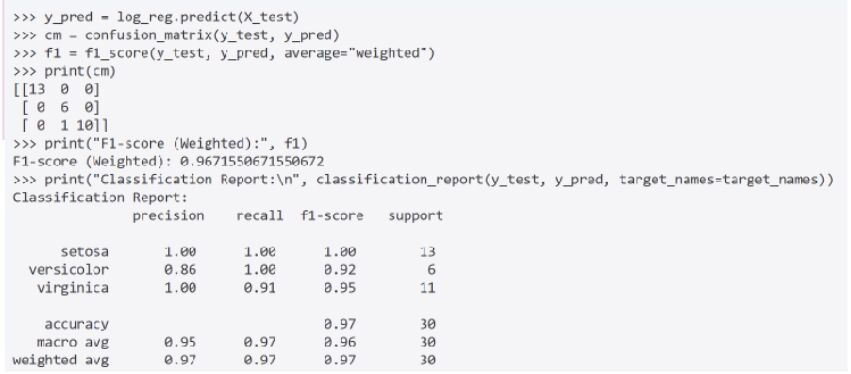 (A)cm 表示混淆矩陣,橫列表測試集的預測值; (B)混淆矩陣對角線數值皆大於非對角線數值表示模型過度擬合; (C)f1_score 參數 average="weighted"表示計算平均 f1_score; (D)f1_score 計算時採用各類別精確率(Precision)與召回率(Recall)的調和平均,並加權考量類別不平衡性